
Кто ж его проверит? Искусственный интеллект научили восстанавливать недостающие фрагменты в исторических документах
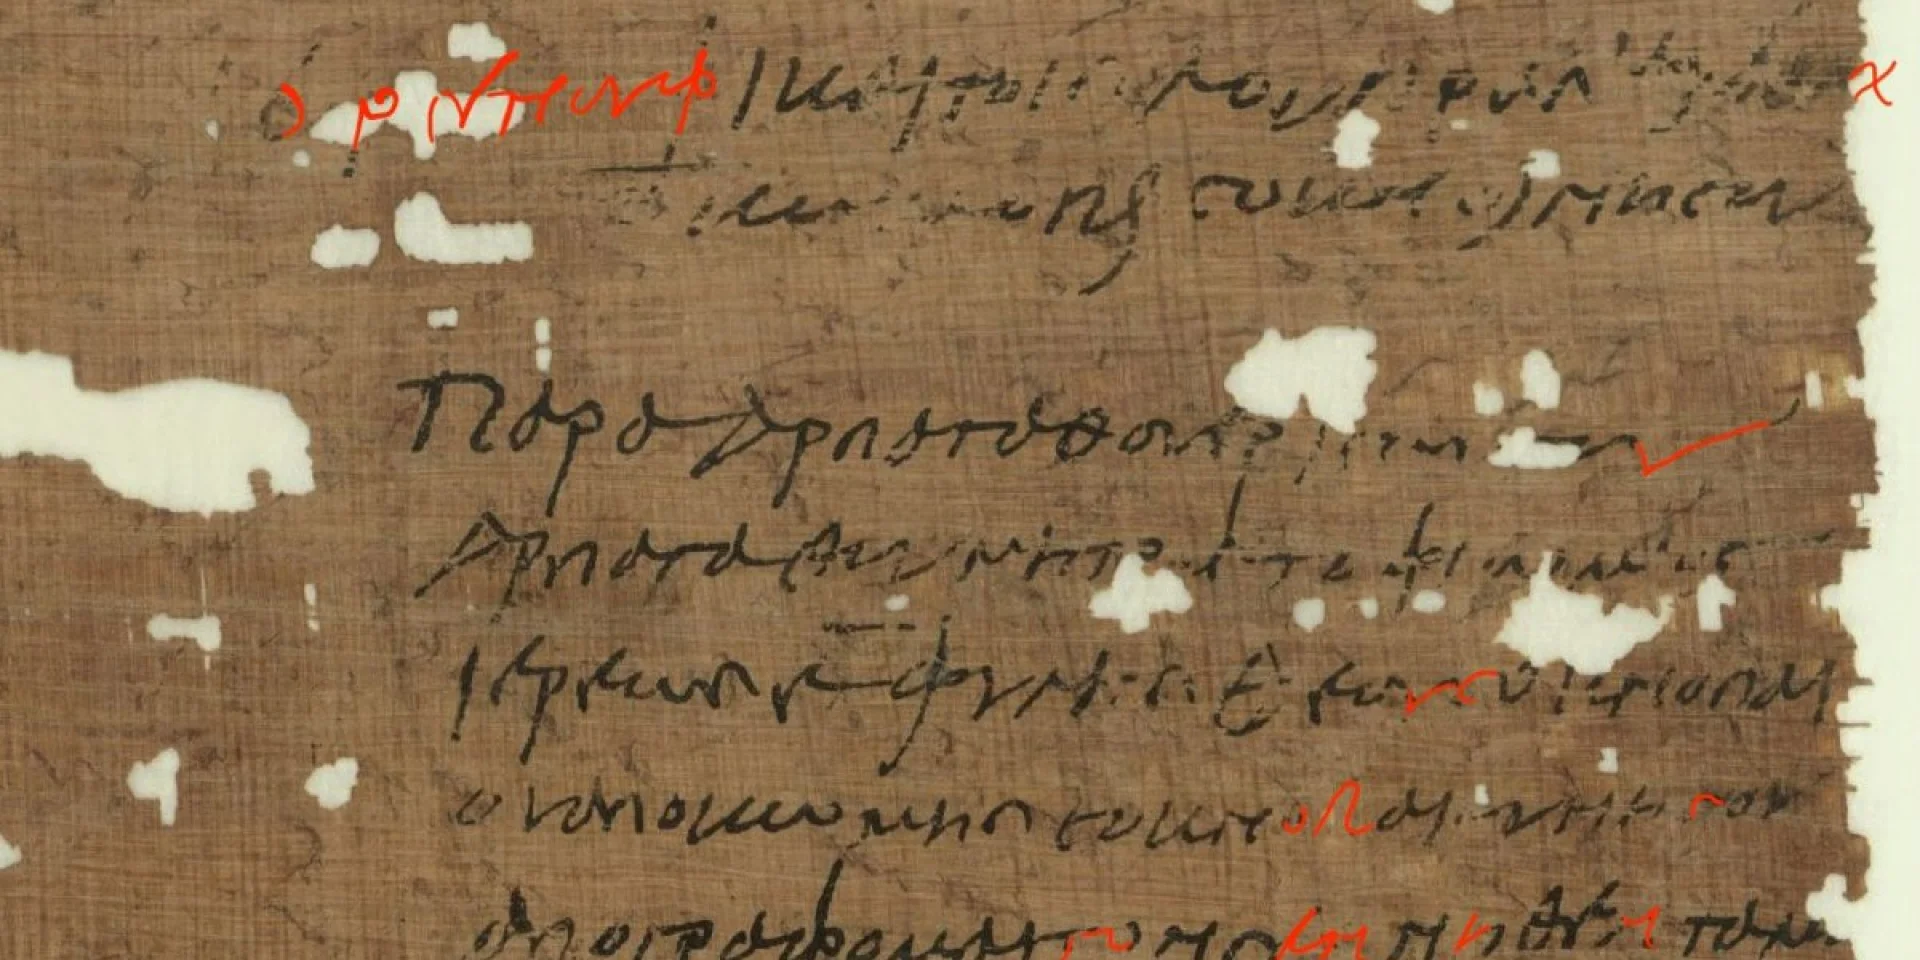
Исследователи разработали первую в мире большую языковую модель (LLM), посвященную древнегреческому языку, используя искусственный интеллект для реконструкции отсутствующих фрагментов в исторических документах.
Систему искусственного интеллекта под названием Apollo разработала Австрийская академия наук (ÖAW) в сотрудничестве с европейскими компаниями в сфере ИИ — Mistral AI и SAIL Reply. Технология, представленная 23 сентября 2026 года, призвана помочь археологам и историкам расшифровать фрагментарные тексты, которые оставались неполными на протяжении веков, пишет Heritage Daily.
Обученный на корпусе объемом около 600 миллионов слов древнегреческого языка, Apollo способен анализировать сохранившиеся фрагменты и за считанные секунды предлагать правдоподобные реконструкции пропущенных слов, предложений и более крупных отрывков. Первая версия системы теперь находится в открытом доступе для исследователей и широкой общественности, открывая новые возможности для изучения обширных коллекций древних документов, хранящихся в музеях и библиотеках по всему миру.
По данным Австрийской академии наук, 92 процента папирусов до сих пор ожидают расшифровки, что представляет собой огромный массив исторических свидетельств, которые еще предстоит всесторонне изучить. Реконструкция этих документов традиционно требует специальных знаний древних языков, исторического контекста и норм письменности различных эпох. Даже опытные ученые могут потратить немало времени, пытаясь восстановить всего несколько утраченных слов. Apollo призван ускорить этот процесс: система анализирует сохранившийся текст и предлагает варианты реконструкции, которые исследователи могут оценить, сопоставив их с оригинальным материалом.
В отличие от универсального чат-бота с искусственным интеллектом, эта система была разработана специально для древнегреческого языка, что позволяет ей распознавать лингвистические закономерности и предлагать дополнения, отражающие лексику, грамматику и стиль исторических текстов.
Несмотря на то, что по современным стандартам искусственного интеллекта Apollo обучался на относительно небольшом наборе данных, он продемонстрировал многообещающие результаты в реконструкции поврежденных текстов. В то время как обычные большие языковые модели часто обучаются на десятках миллиардов слов, Apollo был разработан с использованием примерно 600 миллионов слов древнегреческого языка. В ходе тестов, включавших оригинальные папирусные тексты с намеренно скрытыми фрагментами, модель правильно восстановила около 80 процентов отсутствующего содержания.
«При наличии оригинального текста на папирусе модель достигает около 80 процентов успеха в отношении замаскированных — то есть намеренно скрытых — фрагментов», — пояснила Анна Долганова, исследовательница Австрийского археологического института (ÖAW), руководившая проектом.
Система также прошла оценку в рамках слепого исследования с участием международных экспертов, сравнивавших ее предложения с реконструкциями, выполненными учеными. В 77% случаев эксперты оценили дополнения, предложенные Apollo, как не уступающие по качеству реконструкциям, созданным человеком. В 16–20% случаев они сочли предложения искусственного интеллекта более удачными. Эти результаты свидетельствуют о том, что специализированные языковые модели могут стать ценными инструментами для исследователей, особенно при работе с поврежденными текстами, допускающими несколько вариантов интерпретации.
Одной из важнейших способностей Apollo является умение различать различные периоды и стили древнегреческого языка. Язык претерпел значительные изменения на протяжении веков, и лексика, а также грамматические нормы гомеровской поэзии существенно отличаются от тех, что характерны для документов эпохи римского правления. Apollo способен выявлять эти различия, опираясь на такие контекстуальные признаки, как структура предложений и словарный состав.
Например, модель может распознавать языковой регистр, характерный для «Одиссеи» Гомера, и предлагать дополнения, отражающие её особый стиль. Эта способность особенно важна при реконструкции документов, дата, происхождение или литературный контекст которых могут быть неопределёнными.
Во время первой презентации системы исследователи продемонстрировали возможности «Аполлона» на трех исторических примерах. Один из них касался греческого уведомления о рождении, датируемого периодом римского владычества в Египте (примерно 149 год н. э.). Искусственный интеллект успешно восстановил недостающие части документа, что демонстрирует его потенциал в деле восстановления древних административных записей.
Apollo также использовали для реконструкции важных фрагментов свитка, обуглившегося во время извержения Везувия в 79 году нашей эры. Извержение, уничтожившее Помпеи и Геркуланум, сохранило коллекцию древних свитков в сильно обугленном виде. Из-за хрупкости изучать их было чрезвычайно сложно. Демонстрация с применением искусственного интеллекта показала, как реконструированные фрагменты могут помочь исследователям интерпретировать текст, восстановленный из столь поврежденного материала.
Третий пример касался фрагментарной надписи из Причерноморья. Её реконструкция показала, что римское право уже действовало в данном регионе, что дополнительно подтверждается свидетельствами о существовании римского налога на проституцию.
Эти примеры иллюстрируют, как восстановление даже небольшой части поврежденного документа может иметь более широкое значение для понимания систем управления, правовых институтов и экономической деятельности в древности. Исследователи полагают, что Apollo может оказаться особенно ценным инструментом для изучения повседневной жизни античной эпохи — области, в которой исторические свидетельства зачастую разбросаны по тысячам сохранившихся документов.
Ранее NV Техно писал, что исследователи при участии Калифорнийского университета в Беркли (США) предлагают искать свинец в чернилах свитков, обугленных в результате извержения Везувия в 79 году. По данным авторов, даже небольшое количество свинца делает буквы различимыми на рентгеновской компьютерной томографии, поскольку металл поглощает больше излучения, чем папирус.
Соавтор работы, изобретатель на пенсии Дуглас Сейлер, говорит, что сейчас многие свитки трудно прочитать из-за низкого контраста между углеродными чернилами и углеродной бумагой.