
Хто ж його перевірить? Штучний інтелект навчили відновлювати відсутні фрагменти в історичних документах
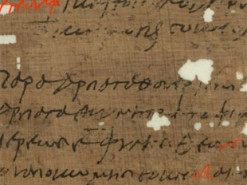
Дослідники розробили першу у світі велику мовну модель, присвячену давньогрецькій мові, використовуючи штучний інтелект для реконструкції відсутніх уривків в історичних документах.
Систему штучного інтелекту під назвою Apollo розробила Австрійська академія наук (ÖAW) у співпраці з європейськими компаніями зі штучного інтелекту Mistral AI та SAIL Reply. Технологія, представлена 23 вересня 2026 року, розроблена, щоб допомогти археологам та історикам розшифрувати фрагментарні тексти, які залишалися неповними протягом століть, пише Heritage Daily.
Навчений приблизно 600 мільйонам слів давньогрецької мови, Apollo може аналізувати збережені уривки та пропонувати правдоподібні реконструкції пропущених слів, речень та довших уривків за лічені секунди. Перша версія системи тепер вільно доступна для дослідників та громадськості, відкриваючи нові можливості для вивчення величезних колекцій стародавніх документів, що зберігаються в музеях та бібліотеках по всьому світу.
За даними Австрійської академії наук, 92 відсотки папірусів досі чекають на розшифровку, що являє собою величезний масив історичних свідчень, які ще належить до кінця дослідити. Реконструкція цих документів традиційно вимагає спеціальних знань стародавніх мов, історичного контексту та писемних норм різних періодів. Навіть досвідчені вчені можуть витратити значний час, намагаючись відновити кілька відсутніх слів. Apollo прагне пришвидшити цей процес, аналізуючи збережений текст і створюючи можливі реконструкції, які дослідники можуть оцінити порівняно з оригінальним матеріалом.
На відміну від універсального чат-бота зі штучним інтелектом, система була розроблена спеціально для давньогрецької мови, що дозволяє їй розпізнавати лінгвістичні закономірності та пропонувати доповнення, що відображають словниковий запас, граматику та стиль історичних текстів.
Незважаючи на те, що за сучасними стандартами штучного інтелекту Apollo навчався на відносно невеликому наборі даних, він продемонстрував багатообіцяючі результати у реконструкції пошкоджених текстів. У той час як звичайні моделі великих мов часто навчаються на десятках мільярдів слів, Apollo був розроблений з використанням приблизно 600 мільйонів слів давньогрецької мови. У тестах, що включали оригінальні папірусні тексти з навмисно прихованими уривками, модель правильно реконструювала близько 80 відсотків відсутнього вмісту.
«З існуючим оригінальним текстом на папірусі модель досягає близько 80 відсотків успіху для замаскованих, тобто навмисно прихованих, уривків», — пояснила Анна Долганова, дослідниця Австрійського археологічного інституту Австрійської австрійської археології (ÖAW), яка керувала проєктом.
Систему також оцінювали в сліпому дослідженні за участю міжнародних експертів, які порівнювали її пропозиції з реконструкціями, проведеними вченими-людьми. Експерти оцінили запропоновані Apollo доповнення щонайменше як такі ж хороші, як і реконструкції, створені людиною, у 77% випадків. У 16−20% випадків вони вважали пропозиції штучного інтелекту кращими. Ці результати свідчать про те, що спеціалізовані мовні моделі можуть стати цінними дослідницькими інструментами, особливо коли вчені стикаються з пошкодженими текстами, що містять кілька можливих інтерпретацій.
Одна з найважливіших здібностей Apollo — це його здатність розрізняти різні періоди та стилі давньогрецької мови. Мова значно розвивалася протягом століть, а словниковий запас і граматичні норми гомерівської поезії суттєво відрізняються від тих, що містяться в документах, створених за часів римського правління. Apollo може визначити ці відмінності, використовуючи контекстуальні підказки, такі як структура речень та словниковий запас.
Наприклад, модель може розпізнавати лінгвістичний регістр, пов’язаний з Одіссеєю Гомера, та генерувати пропозиції щодо доповнень, що відображають її особливий стиль. Ця здатність особливо важлива під час реконструкції документів, дата, походження чи літературний контекст яких можуть бути невизначеними.
Під час першої презентації системи дослідники продемонстрували можливості «Аполлона» на трьох історичних прикладах. Одна з них стосувалася грецького оголошення про народження з часів Римського Єгипту, приблизно 149 рік нашої ери. Штучний інтелект успішно реконструював відсутні частини документа, що ілюструє його потенціал для відновлення адміністративних записів з давнини.
Третій приклад стосувалося фрагментарного напису з регіону Чорного моря. Його реконструкція засвідчила, що римське право вже діяло в певному регіоні, що додатково підтверджується доказами римського податку на проституцію.
Ці приклади ілюструють, як відновлення навіть невеликої частини пошкодженого документа може мати ширші наслідки для розуміння стародавнього управління, правових систем та економічної діяльності. Дослідники вважають, що Apollo може бути особливо цінним для вивчення повсякденного життя в античності, області, в якій історичні докази часто розкидані по тисячах збережених документів.
Раніше NV Техно писав, що дослідники за участі Каліфорнійського університету в Берклі (США) пропонують шукати свинець у чорнилі сувоїв, які обвуглило виверження Везувію 79 року. За даними авторів, навіть трохи свинцю робить літери помітними на рентгенівській КТ, бо метал поглинає більше випромінювання, ніж папірус.
Співавтор роботи, винахідник на пенсії Дуглас Сейлер, каже, що зараз багато сувоїв важко прочитати через низький контраст вуглецевого чорнила на вуглецевому папері.
Источник: techno.nv.ua