


Xiaomi представила HySparse2: архітектуру для довгих діалогів
Компанія Xiaomi представила нову ключову архітектуру HySparse2 для своєї моделі MiMo-V3. Ця інновація спрямована на оптимізацію обробки даних та покращення ефективності роботи з довготривалими діалогами та складними завданнями, які вимагають обробки великих обсягів інформації.
HySparse2: революція у роботі з довгим контекстом
HySparse2 розроблена для роботи з багатоетапними агентами (Agent), що вимагають обробки довгих контекстів. Нова архітектура покликана зменшити обчислювальні витрати під час попередньої обробки даних (Prefill), скоротити обсяг пам’яті, необхідної для кешування ключових значень (KV Cache), та забезпечити точніший пошук критично важливої інформації у зростаючій історії завдань.
З моменту випуску Xiaomi MiMo-V2, компанія постійно працює над покращенням як функціональності моделей, так і їх обчислювальної ефективності. Архітектура Hybrid SWA, що використовувалася в MiMo-V2, поєднувала повноцінну увагу (Full Attention) зі зсувним віконним механізмом (Sliding Window Attention), забезпечуючи високу якість моделі при одночасному підвищенні ефективності навчання та виведення.
За останнє півріччя, Xiaomi активно експериментувала з методами навчання з підкріпленням (RL), застосовуючи набутий досвід до серії MiMo-V2.6, що значно покращило можливості моделі. Паралельно з розвитком V2, активно велася розробка архітектури нового покоління для MiMo-V3. Першим кроком на цьому шляху стала архітектура HySparse.
Сьогодні Xiaomi презентує HySparse2 – ключову архітектуру для MiMo-V3. Вона базується на HySparse, але вдосконалює механізми спільного використання KV (KV sharing) та вибору за розрідженістю (sparse selection), що робить обробку довготривалого контексту ще більш ефективною та точною.
Виклики роботи з довгим контекстом для Agent’ів
Сучасні Agent’и часто стикаються з необхідністю обробки великих обсягів даних, отриманих, наприклад, з веб-сторінок, документів чи логів виконання інструментів. Кожен новий крок у виконанні завдання вимагає аналізу нових вхідних даних та вилучення релевантної інформації з попередньої історії.
Моделі зберігають представлення прочитаної інформації у KV Cache для подальшого використання. Процес завантаження нових даних та побудови цих кешів називається Prefill. У багатоетапних завданнях Agent’ів, при кожному отриманні нової інформації, необхідно повторно обробляти ці дані. Тому нова архітектура повинна відповідати трьом ключовим вимогам:
- Ефективне завантаження: Зменшення обчислень для обробки довгих входів, щоб модель могла швидше переходити до наступного етапу генерації.
- Економія пам’яті: Зменшення використання KV Cache, щоб довга історія завдань могла зберігатися довше.
- Точний пошук: Виявлення релевантних доказів у довгій історії для точної інтеграції інформації між різними етапами.
Перша версія HySparse вже зробила крок у цьому напрямку, використовуючи невелику кількість шарів Full Attention для надання KV Cache та результатів вибору ключових позицій, які потім повторно використовувалися розрідженими шарами (Sparse Attention). Це зменшило обчислювальні витрати та навантаження на кеш. Однак, у HySparse Prefill все ще вимагав виконання всіх шарів, а блоковий вибір міг бути менш точним при пошуку інформації на великих відстанях.
HySparse2 вирішує ці проблеми шляхом впровадження двоступеневого спільного використання KV, розрідженого вибору на рівні токенів та уніфікованого доступу до локальної інформації.
Двоступеневе спільне використання KV: прискорення готовності KV Cache
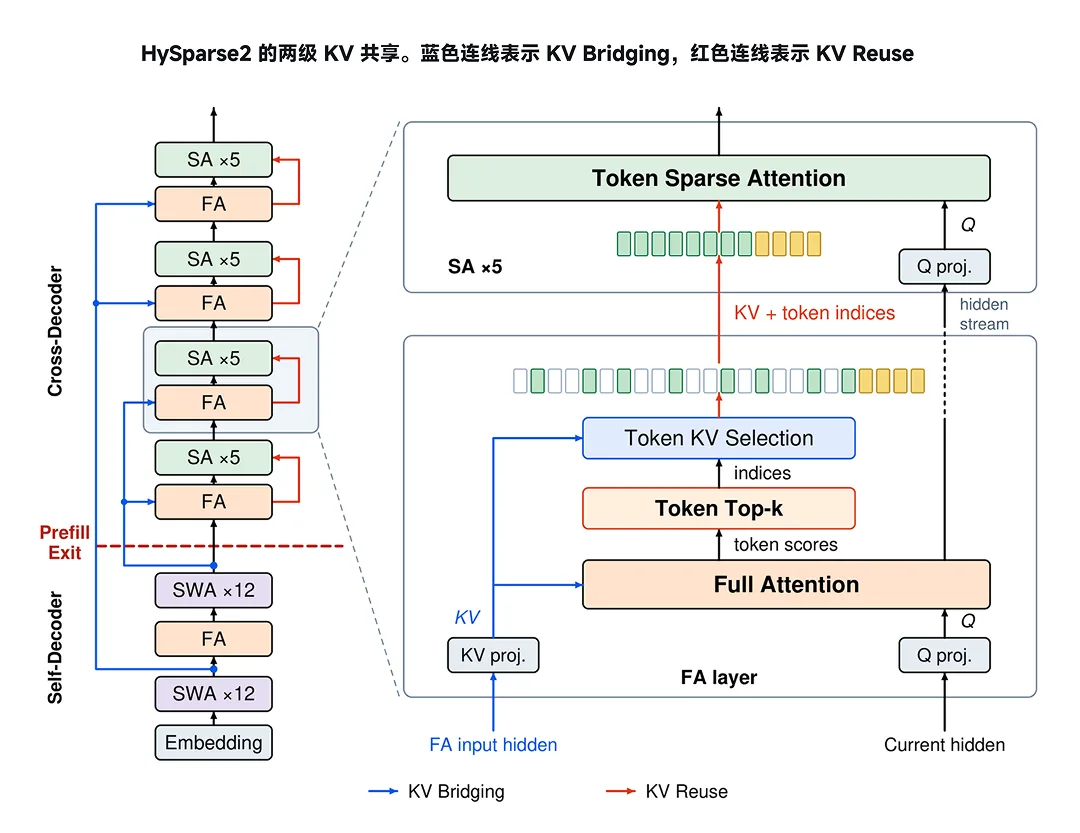
HySparse2 розділяє модель на дві частини: Self-Decoder (передня частина) та Cross-Decoder (задня частина). У Self-Decoder використовується гібридна структура Full Attention та SWA, а в Cross-Decoder – гібридна структура Full Attention та Sparse Attention.
Спільне використання KV відбувається на двох рівнях:
- KV Bridging: KV Cache для задньої частини моделі будується заздалегідь, використовуючи приховані стани передньої частини. Кожен шар Full Attention у задній частині генерує свій KV Cache на основі відповідного шару у передній частині. Це дозволяє уникнути очікування повного проходження даних через усі шари передньої частини.
- KV Reuse: У межах одного гібридного блоку (Hybrid Block), що складається з одного шару Full Attention та кількох шарів Sparse Attention, KV Cache та результати вибору позицій, отримані Full Attention, повторно використовуються наступними розрідженими шарами. Це дозволяє ефективно використовувати інформацію, що надається шарами Full Attention, без необхідності тренування окремого селектора.
Точніший вибір на рівні токенів та збереження локального контексту
На відміну від HySparse, яка використовувала блоковий вибір, HySparse2 переходить до вибору на рівні окремих токенів. Це дозволяє більш точно розподіляти обчислювальні ресурси уваги, особливо при роботі з довгими контекстами, де важливі токени можуть бути розкидані. Тестування на задачах RULER-v2, MRCR-v2 та GraphWalks показало значне покращення завдяки більш детальному вибору.
Окрім глобального пошуку, модель зберігає доступ до найближчого контексту. HySparse2 примусово виділяє останні 128 токенів та додатково обирає 1,024 глобальних токени поза цим вікном. Ці два набори даних спільно використовують KV Cache, наданий шарами Full Attention.
Важливою зміною є об’єднання доступу до локальної та глобальної інформації в одному обчисленні розрідженої уваги. Раніше локальна інформація вимагала окремої гілки SWA, що ускладнювало процес і вимагало додаткових обчислень. Тепер обидва типи інформації доступні з KV Cache, підготовленого ще на етапі Self-Decoder. Це усуває залежність від обчислень Cross-Decoder для формування локального кешу.
Експерименти показали, що примусове виділення локального вікна підтримує конкурентоспроможність моделі у завданнях з довгим контекстом, одночасно зменшуючи витрати на параметри та KV Cache завдяки відсутності окремої гілки SWA.
Prefill скорочено вдвічі, зменшення навантаження на розгортання
Завдяки двоступеневому спільному використанню KV та об’єднанню локального вікна, весь KV Cache, необхідний для задньої частини моделі, може бути побудований з прихованих станів передньої частини. Це дозволяє завершити побудову KV Cache одразу після обчислення Self-Decoder та KV Bridging.
У моделі з 49 шарами, Prefill тепер вимагає виконання лише перших 25 шарів Self-Decoder та KV Bridging, з одним шаром Full Attention. Це означає, що для розгортання Prefill-вузла достатньо лише цієї частини мережі Self-Decoder, що майже вдвічі скорочує необхідний обсяг пам’яті для моделі.
Таким чином, оптимізація розширюється від скорочення обчислень уваги до зменшення шляху обчислень для довгих входів. Етап генерації залишається повним, продовжуючи використовувати можливості моделі для глобального пошуку та моделювання.
Менші витрати, вища швидкість, краща робота з довгим текстом
Порівняння архітектур Hybrid SWA, HySparse та HySparse2 на 80B-A3B MoE моделі (з однаковими даними та процесом навчання, але різним дизайном уваги та більш компактною конфігурацією MQA в HySparse2) показало значні переваги HySparse2.
- При мільйоні токенів: Порівняно з Hybrid SWA, Prefill-обчислення HySparse2 скоротилися в 5 разів, а KV Cache – з 12 ГБ до 2.7 ГБ. У порівнянні з HySparse, Prefill-обчислення HySparse2 зменшилися в 3 рази, а KV Cache – з 6.7 ГБ до 2.7 ГБ.
- Покращення пошуку та моделювання контексту: Після однакового легкого донавчання, HySparse2 продемонструвала вищі показники MRCR-v2 та RULER-v2 (оцінка пошуку та відповідей у довгому контексті) та нижчі AgentPPL, LongPPL (оцінка прогнозування токенів у довгострокових залежностях) в діапазоні до 256k токенів. Середнє покращення MRCR-v2 та RULER-v2 для HySparse2 порівняно з HySparse становило 11.30 та 19.81 відсоткових пунктів відповідно.
Ці результати підтверджують, що менший KV Cache та коротший Prefill можуть співіснувати з покращеним пошуком у довгому контексті. HySparse2 створює більш ефективну архітектурну основу для багатоетапних Agent’ів з довгим контекстом.
Від введення до генерації: зменшення часу очікування для кожного раунду
Завершення завдання Agent’ом вимагає постійного читання інформації, генерації дій та подальшого просування на основі отриманих результатів. Ефективність кожного такого циклу безпосередньо впливає на загальний час очікування користувача.
Раніше MiMo-UltraSpeed, завдяки синергії моделі та системи (низькобітна квантизація, спекулятивне декодування, MegaKernel), фокусувалася на прискоренні декодування. Сьогодні HySparse2 додатково знижує витрати на Prefill та кешування для довготривалого контексту. Ці два напрямки роботи – обробка введення та генерація виведення – спрямовані на підвищення загальної ефективності моделі.
Xiaomi прагне інтегрувати ці розробки для MiMo-V3, щоб, окрім підвищення інтелекту моделі, запропонувати користувачам швидший Prefill та Decode при однаковому розмірі моделі, допомагаючи їм швидше виконувати складніші завдання.
Джерело: https://www.ithome.com/1/006/839.htm
Источник: HiTech
 Поделиться